RLHF Services
Align your AI models with human preferences through our comprehensive RLHF services. Our trained raters provide high-quality preference data to fine-tune your models for better performance.
- Mutual NDA on every engagement
- Pilot batch before you commit
What's included
- Preference Ranking
- Reward Model Training Data
- Constitutional AI Support
- Human-in-the-Loop Feedback
- Quality Calibration
350+
Vetted SMEs
PhD & domain experts
99.5%
Inter-Rater Agreement
Calibrated feedback
180+
Languages & Dialects
Global evaluations
24/7
Rotational Sprints
Multi-timezone coverage
Comprehensive Service Capabilities
Preference Ranking
Systematic ranking of model outputs based on quality criteria.
Reward Model Training Data
High-quality comparison data for training reward models.
Constitutional AI Support
Help develop and enforce AI behavioral guidelines.
Human-in-the-Loop Feedback
Continuous feedback integration during model training.
Quality Calibration
Regular calibration sessions to ensure consistent ratings.
Custom Rubric Development
Tailored evaluation criteria for your specific use case.
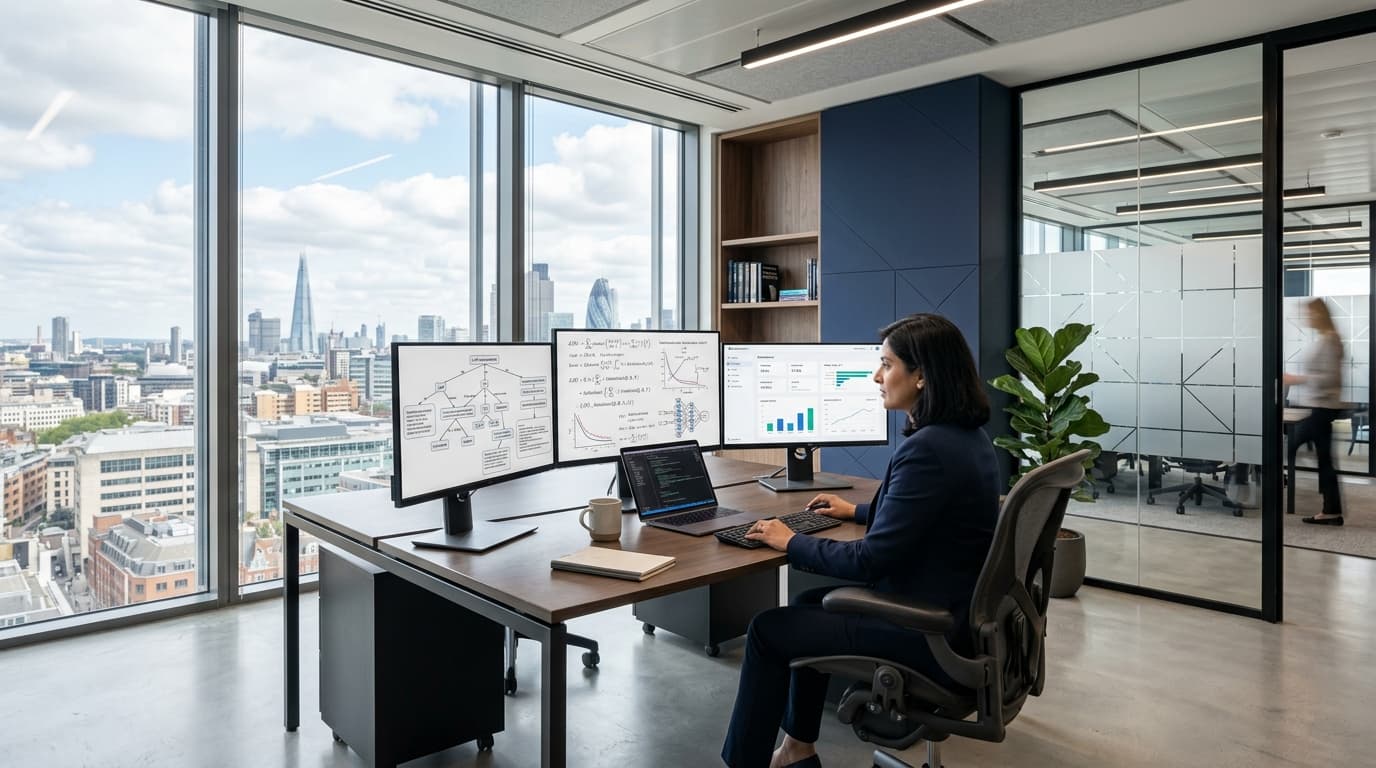
Dedicated RLHF Services Production Facility
PhD & STEM subject matter experts conducting multi-turn reasoning trace verification, adversarial red-teaming, and rubric scoring.
Common Use Cases
Institutional Delivery Advantage
- Trained raters with domain expertise
- Consistent inter-rater reliability
- Scalable feedback collection
- Fast turnaround for training iterations
- Detailed annotation guidelines
- Quality assurance protocols
24-Hour
Priority Batches Available
Weekly
Calibration Sessions
Custom
Rubric Development
NDA
Protected Data Handling
Deploy Specialized RLHF Services Capacity
Schedule a confidential consultation to review volumes, turnaround SLAs, and bilateral calibration rubrics.